Вынужденный переход на локальное распознавание речи принес неожиданные преимущества
Разрыв партнерства с Yandex Kazakhstan заставил компанию искать альтернативы облачному SpeechKit, что привело к созданию локального решения, превосходящего по качеству распознавания казахского и узбекского языков.

Компания, партнер Yandex Kazakhstan, использовала в продукте для речевой аналитики SpeechKit и YandexGPT. В конце 2025 года Yandex Kazakhstan разорвал соглашение, решив, что ему не нужен партнер с собственным продуктом, даже на его технологиях.
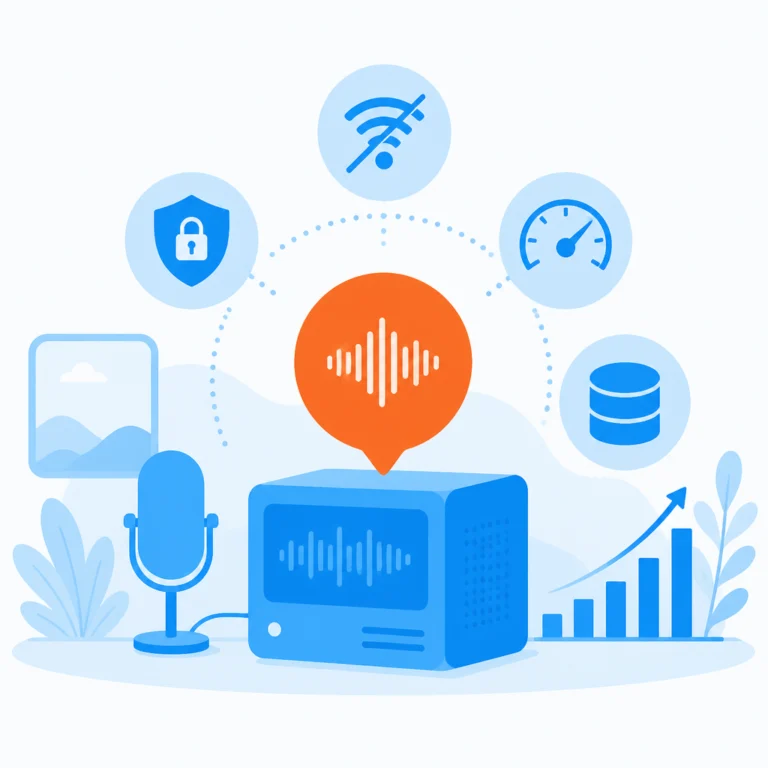
Первым шагом стал поиск альтернатив на рынке облачных решений для распознавания речи. Компания нашла сервис Gladia, который показался лучше SpeechKit. Однако ключевым запросом клиентов было локальное развертывание системы из-за требований безопасности данных. Облачный SpeechKit не подходил. У него также были проблемы с качеством распознавания казахского и, по данным Habr, "беда с распознаванием узбекского языка". Потребность в локальности и низкое качество для специфичных языков заставили разработать собственное решение.
Переход показал неожиданный результат: локальное развертывание модели на видеокарте дало намного лучшее качество распознавания казахского и узбекского языков по сравнению с прежним облачным провайдером. Это качество достигнуто в ущерб производительности - инженерам пришлось искать компромисс. Собственный speech-to-text сервер позволил взять контроль над данными и тонко настроить модель под лингвистические особенности, с которыми не справлялся универсальный облачный сервис.
Эта история иллюстрирует несколько трендов. Во-первых, растущий спрос на локальные (on-premise) решения для ИИ в сферах с чувствительными данными, где важны приватность и суверенитет данных. Во-вторых, ограничения крупных универсальных облачных API при работе с низкоресурсными или специфичными языками. Кастомизация и локальный контроль дают здесь решающее преимущество. Для разработчиков и предпринимателей это сигнал: зависимость от одной облачной платформы несет риски, а инвестиции в собственные экспертизу и инфраструктуру могут окупиться в качестве конечного продукта. Ситуация ведет к диверсификации инструментов и росту рынка компактных моделей для edge-устройств или локальных серверов.
Анализ и выводы Кейс демонстрирует классическую проблему вендор-локинга и его последствия. Когда партнерство с крупным провайдером (Yandex Kazakhstan) внезапно прекращается, как это случилось в 2025 году, компания вынуждена искать срочные альтернативы. Изначальный выбор пал на другой облачный сервис (Gladia), но фундаментальное требование клиентов - локальное развертывание - сразу отсекло все облачные варианты, включая прежний SpeechKit. Это не просто вопрос удобства, а жесткое условие безопасности, с которым сталкиваются многие бизнесы, работающие с персональными или конфиденциальными данными.
Техническая проблема усугублялась языковой спецификой. Универсальные облачные модели часто показывают низкое качество на низкоресурсных языках, что и подтвердилось с казахским и узбекским. Цитата с Habr о "беде с распознаванием узбекского языка" точно отражает суть проблемы. Создание собственного локального решения стало не просто альтернативой, а необходимостью для сохранения продукта.
Результат - значительный выигрыш в качестве распознавания для целевых языков. Это было достигнуто за счет полного контроля над моделью и данными, возможности тонкой настройки под фонетику и грамматику. Однако такая кастомизация имеет свою цену: инженерам пришлось балансировать между качеством и производительностью, оптимизируя модель для работы на конкретном железе (видеокарте).
Главный урок для рынка: монопольная зависимость от одного облачного API рискованна как в бизнес-смысле (внезапное расторжение договоров), так и в техническом (негибкость под специфичные задачи). Тренд на суверенитет данных и языковое разнообразие будет усиливать спрос на локальные, кастомизируемые решения. Это, в свою очередь, стимулирует развитие более компактных и эффективных моделей, способных работать на edge-устройствах и собственных серверах компаний, снижая внешние риски и повышая качество там, где универсальные сервисы не справляются.