Асимметрия как принцип: почему тестирование ИИ - это поиск ошибок, а не доказательство совершенства
Статья на Habr предлагает использовать логическую асимметрию как ключевой принцип тестирования ИИ-моделей, где одна найденная ошибка опровергает их безупречность, а бесконечное число успешных тестов не гарантирует её. Этот подход, восходящий к Аристотелю и Дейкстре, смещает фокус с простого накопления подтверждений на целенаправленный поиск контрпримеров или формальные доказательства, что критически важно для создания надежных систем.

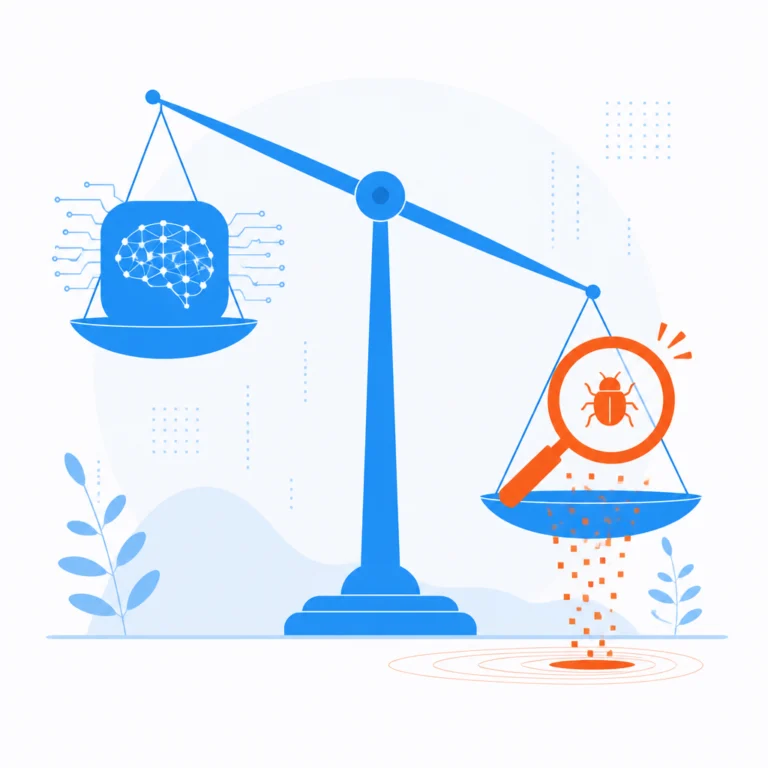
При проверке ИИ-моделей работает ключевой логический принцип: один контрпример опровергает общее утверждение, а сколько угодно успешных тестов не доказывает безупречность. Этот подход, идущий от Аристотеля, стал практическим методом валидации ИИ.
В конце 1960-х Эдсгер Дейкстра сформулировал это для IT-сообщества: "Тестирование показывает наличие ошибок, но никогда не доказывает их отсутствие". Для современных сложных и не всегда прозрачных нейросетей эта мысль актуальна как никогда. Серия успешных тестов лишь повышает вероятность правильности модели, но не даёт абсолютной гарантии.
Из этой асимметрии следуют конкретные методологии тестирования. Разумная стратегия требует сместить фокус с накопления положительных результатов на активный поиск опровергающих случаев - контрпримеров, вскрывающих уязвимости или опасные паттерны. Альтернатива - переход к формальному доказательству свойств модели, что для современных архитектур часто нереалистично сложно. Промежуточный вариант - работа над статистическими гарантиями надёжности.
В чувствительных областях вроде автономного вождения, меддиагностики или модерации принятие этой парадигмы критически важно. Это меняет культуру разработки и QA, заставляя инженеров мыслить как "взломщики" своих систем и постоянно искать условия для сбоя. Такой подход повышает фактическую надёжность продуктов для пользователей. Внедрение методологии поиска контрпримеров может привести к более строгим стандартам тестирования, развитию инструментов для adversarial-тестирования и в итоге - к более безопасному ИИ.
Идея, обсуждаемая в статье на Habr (https://habr.com/ru/articles/1088722/), - это прямой призыв к действию. Она ведёт от иллюзии контроля через большие числа успешных тестов к зрелому пониманию ограничений машинного интеллекта. Будущее тестирования ИИ, вероятно, будет строиться вокруг систематического создания сложных краевых случаев и сценариев, не встречавшихся при обучении. Это путь к системам, чьё поведение можно не только надеяться предсказать, но и в какой-то мере гарантировать. Принцип, сформулированный в 1960-х, остаётся фундаментальным для проверки любых сложных систем, включая современные нейросети.