SESAME: российская модель шумоподавления речи адаптирует архитектуру MoE из LLM для аудио
Студенты НИУ ВШЭ и VK представили модель SESAME, которая применяет архитектуру разреженной смеси экспертов (sparse MoE) из больших языковых моделей для эффективного подавления разных типов шумов в речи.

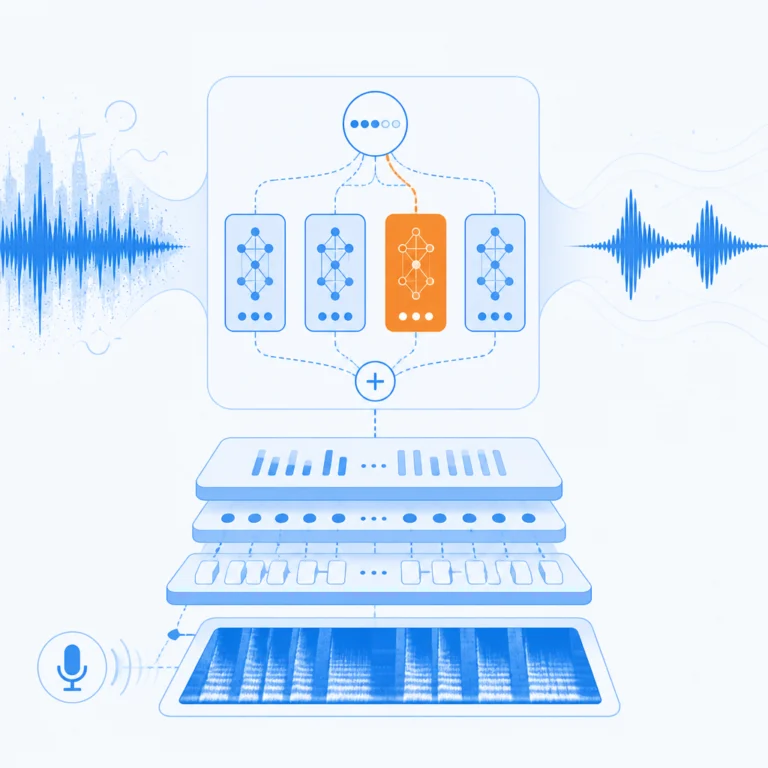
Исследователи из НИУ ВШЭ и VK разработали модель шумоподавления речи SESAME. Ее основа - разреженная смесь экспертов (MoE), архитектура, ставшая стандартом для больших языковых моделей, но редко используемая в обработке аудио. Вместо обработки всего сигнала одной сетью, разные "эксперты" внутри модели учатся работать с разными типами акустических помех.
Модель построена на архитектуре MP-SENet, где стандартные блоки заменены на MoE-модуль. В ходе работы команда протестировала разные подходы. Например, метод Expert Choice, эффективный в LLM, для аудиозадач не подошел. В финальной версии используется 4 эксперта, из которых во время работы активируются 3.
Для обучения использовался публичный датасет VoiceBank-DEMAND, содержащий 399 чистых записей речи и 1 час шумов. Общий объем обучающей выборки составил 80201 аудиосегмент. По результатам тестов, SESAME показала высокие результаты по метрикам PESQ и STOI. Базовая MP-SENet без MoE дала схожие результаты по этим метрикам. Хотя абсолютный показатель PESQ у MoE-версии чуть ниже, эта архитектура создает более вычислительно эффективную систему, где части сети специализируются на конкретных задачах.
Эффективное шумоподавление необходимо для голосовых ассистентов, систем видеоконференций, телекома и устройств умного дома. Перенос подходов вроде MoE из LLM в аудиодомен позволяет создавать более специализированные и эффективные модели, не наращивая параметры единой сети. Активация 3 из 4 экспертов дает баланс между качеством и вычислительными затратами.
Работа указывает на тренд кросс-доменного переноса архитектур. Смеси экспертов, доминировавшие в тексте, теперь применяются для аудио, а в перспективе - и для видео. Для пользователей это может означать улучшение качества связи в шумных условиях без требований к железу. Открытый код модели дает разработчикам возможность для экспериментов и может ускорить появление новых гибридных решений. Код проекта выложен на GitHub, что соответствует открытой практике в научной среде и позволяет независимо проверить заявленные результаты, включая цифры по датасету и производительности.