Sber AI Lab представила фреймворк SplitLight для стандартизации подготовки данных в рекомендательных системах
Исследователи из Sber AI Lab создали инструмент, который решает ключевую проблему воспроизводимости экспериментов в рекомендательных системах - неявные различия в подготовке датасетов.

SplitLight: стандарт для подготовки данных в рекомендательных системах
Специалисты Sber AI Lab Алексей Васильев и Анна Володкевич представили фреймворк SplitLight. Он стандартизирует подготовку датасетов и разбиение данных для офлайн-оценки рекомендательных систем.
Основная проблема воспроизводимости экспериментов часто кроется не в моделях, а в скрытых деталях подготовки данных. Речь о разных фильтрах, обработке временных меток и агрегациях, которые не описываются в статьях. Это приводит к некорректному сравнению результатов. На практике исследователи сталкиваются с ситуацией, когда результаты, заявленные в научной статье, не удается воспроизвести, несмотря на совпадение ключевых параметров пайплайна. Процедура подготовки данных зачастую сильнее влияет на итоговый результат сравнения моделей, чем детали реализации самой модели.
Например, формулировка "датасет Zvuk, global temporal split с квантилем 0,9" не раскрывает ключевые детали: какие фильтры и агрегации применялись, как обрабатывались события с одинаковыми временными метками и повторные взаимодействия, удалялись ли холодные объекты. В результате два пайплайна с одним датасетом и одинаковым названием разбиения могут оценивать разные постановки задачи.
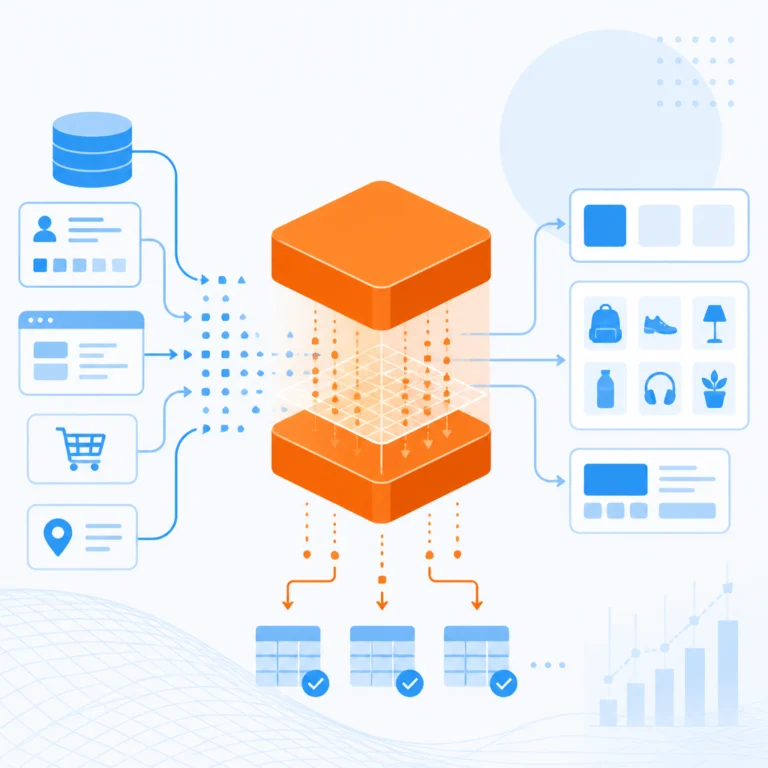
Фреймворк SplitLight решает эту проблему, предоставляя единый стандарт для описания и реализации ключевых этапов подготовки данных. Он включает компоненты для фильтрации данных, агрегации событий, обработки временных меток и разбиения на обучающую и тестовую выборки.
В рамках разработки было проанализировано 9 популярных датасетов для рекомендательных систем. Для каждого из них выполнили 6 различных вариантов разбиения данных, что в сумме составило 96 конфигураций. Это позволило выявить, как именно различные подходы к подготовке данных влияют на итоговые метрики моделей.
Внедрение такого стандарта важно для всей отрасли машинного обучения, особенно для рекомендательных систем. Это позволяет повысить воспроизводимость исследований и ускорить процесс разработки новых моделей. Инженеры и ученые смогут быстрее и надежнее сравнивать свои наработки с существующими.
Для бизнеса, который полагается на рекомендательные алгоритмы, это означает возможность более объективно оценивать эффективность внедряемых решений и снижать риски, связанные с выбором неоптимальной модели из-за некорректных тестов. Разработка ведет к большей зрелости индустрии, где акцент смещается с гонки за новыми архитектурами моделей на качество и прозрачность всего цикла разработки ИИ-решений. Стандартизация подготовки данных становится таким же важным элементом, как и стандартизация протоколов оценки.