Как развернуть личный LLM-сервер на своём железе для доступа из любой точки мира
Разработчики и энтузиасты получают возможность обойти платные подписки и API-ограничения, развернув собственную языковую модель на домашнем или арендованном оборудовании.

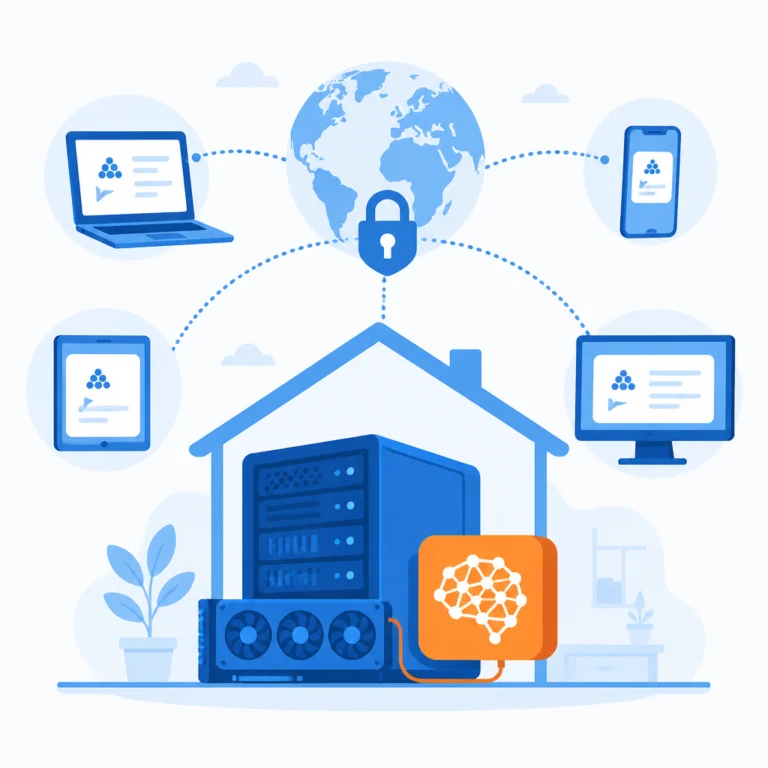
Крупные языковые модели часто доступны только по платной подписке, с квотами или географическими ограничениями. Развернув собственный LLM-сервер, вы получите полный контроль над моделью, её данными и затратами. Сервис будет доступен из любой точки мира по единому адресу - с домашнего ПК, рабочей станции или телефона. Этот подход устраняет зависимость от коммерческих провайдеров и позволяет кастомизировать модель под свои задачи.
Техническая основа решения - связка открытых инструментов. Платформа Ollama служит для локального запуска и управления большими языковыми моделями. Веб-интерфейс, аналогичный ChatGPT, обеспечивает Open WebUI. Для доступа к сервису извне домашней сети настраивается проброс портов на роутере или, надежнее, туннелирующий сервис вроде Cloudflare Tunnel или Tailscale. В руководстве рассматривается настройка через Cloudflare Tunnel - это дает постоянный домен и избавляет от проблем с динамическими IP-адресами и файрволом.
Настройка включает несколько шагов. Установка и настройка Ollama с загрузкой выбранной модели. Развертывание контейнера Open WebUI через Docker и его связь с локальным экземпляром Ollama. Настройка безопасного удаленного доступа: создание учетной записи в Cloudflare, установка агента `cloudflared` и настройка туннеля. Туннель связывает локальный порт веб-интерфейса с публичным доменом от Cloudflare.
После настройки модель доступна по постоянному URL с любого устройства, подключенного к интернету.
Распространение таких практик демократизирует доступ к ИИ-технологиям. Снижается порог входа для экспериментов, прототипирования и даже запуска коммерческих сервисов без привязки к внешним API. Предприниматели и небольшие команды могут создавать внутренние инструменты или нишевые продукты на базе открытых моделей без крупных стартовых затрат. Для пользователей - разработчиков, исследователей, энтузиастов - это означает полную приватность данных, так как все запросы обрабатываются локально, и отсутствие лимитов на использование, кроме ограничений производительности своего оборудования.
У подхода есть ограничения, определяющие его аудиторию. Главное - требования к аппаратным ресурсам. Запуск даже компактных моделей требует мощной видеокарты с большим объемом памяти. Для комфортной работы рекомендуется GPU с памятью не менее шести гигабайт. Решение актуально для тех, у кого уже есть подходящее железо или кто готов в него инвестировать. Кроме того, пользователь сам отвечает за безопасность, обновления и стабильность работы сервера. Однако тренд на локальный и независимый хостинг моделей набирает силу, стимулируя развитие более эффективных компактных моделей и удобных инструментов для их развертывания.