Как работает нейросеть: разбор на пальцах
Простыми словами и без формул: что такое веса и токены, как нейросеть учится на примерах и почему уверенно отвечает даже там, где ошибается. С бытовыми аналогиями и разбором частых заблуждений.

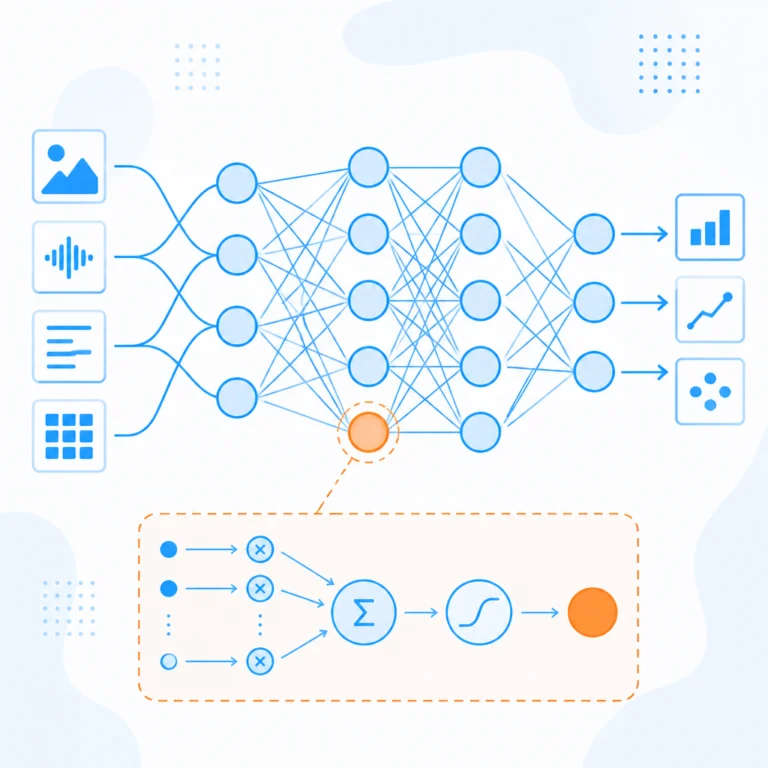
Нейросеть - это программа, которая находит закономерности в множестве примеров и использует их, чтобы предсказывать ответ на новый запрос. Когда спрашивают, как работает нейросеть, короткий честный ответ звучит так: она не думает и не понимает в человеческом смысле, а угадывает наиболее вероятное продолжение по тому, что видела на этапе обучения.
Дальше в этой статье разбираем, из чего нейросеть устроена изнутри и почему её ответы иногда звучат осмысленно, а иногда - нелепо. Без формул, на бытовых примерах.
От нейрона до нейросети
Слово "нейрон" в названии - метафора, а не биология. Искусственный нейрон - это простая арифметическая операция: он берёт несколько чисел на входе, умножает каждое на свой вес, складывает результат и передаёт дальше. Один такой нейрон бесполезен сам по себе. Но если соединить миллионы таких нейронов в слои, где выход одного слоя становится входом для следующего, получается система, способная улавливать сложные зависимости между входом и выходом.
Представьте кухонный комбайн с сотнями лезвий, через который прогоняют текст, а на выходе получают числа, описывающие смысл. Аналогия грубая, но суть отражает: сырой текст на входе превращается в набор чисел, эти числа проходят через десятки слоёв преобразований, и в конце получается новый набор чисел, который переводят обратно в слова.
Веса - это те самые числа, которые умножаются на входные значения. Именно в них хранится всё, чему научилась модель. У современных больших языковых моделей счёт весов идёт на миллиарды, и никто не читает их по отдельности - смысл возникает только в совокупности, как узор в ковре складывается из тысяч отдельных нитей.
Как нейросеть учится
Обучение - это подбор весов методом проб и ошибок, только в промышленных масштабах. Модели показывают пример: скажем, начало предложения, и просят угадать следующее слово. Она выдаёт какое-то предсказание, система сравнивает его с правильным ответом и слегка подправляет веса в ту сторону, где ошибка была бы меньше. Потом берут следующий пример. И следующий. Таких примеров - весь текст, который удалось собрать: книги, статьи, код, переписки.
Один проход через это гигантское количество примеров почти ничего не даёт: веса меняются на крошечную долю. Но если повторить процесс миллиарды раз, постепенно проступает закономерность - не заученные фразы, а статистика того, какие слова обычно идут за какими в каком контексте. Хорошая бытовая аналогия - учить язык не по учебнику, а через погружение: ребёнок сначала не понимает грамматику, но, услышав тысячи раз "я хочу пить" и "я хочу спать", улавливает шаблон и начинает строить похожие фразы сам.
Важная деталь: модель не запоминает исходные тексты дословно и не хранит их где-то внутри в виде архива. Она сохраняет статистические закономерности этих текстов в весах. Поэтому нейросеть может написать вполне связный абзац о том, чего в её обучающих данных не было в таком виде: она комбинирует усвоенные закономерности, а не цитирует.
Как нейросеть отвечает на вопрос
Когда обучение завершено и вы задаёте вопрос, происходит другой процесс - вывод, или инференс. Модель не ищет ответ в базе данных. Она читает ваш текст токен за токеном (токен - это примерно кусок слова или короткое слово целиком), пропускает эту последовательность через все свои слои и на выходе получает распределение вероятностей: какое слово, с какой вероятностью, должно идти следующим.
Дальше система выбирает одно слово - чаще всего не строго самое вероятное, а с элементом случайности, иначе ответы были бы одинаковыми и скучными. Затем добавляет это слово к тексту и повторяет всё заново, чтобы предсказать следующее. Так, слово за словом, собирается весь ответ. Именно поэтому в момент генерации нейросеть не "знает" заранее, чем закончит предложение: она честно предсказывает по одному шагу за раз, опираясь на всё, что написала до этого.
Это объясняет и характерную особенность таких моделей - уверенный тон даже там, где модель ошибается. Она не сверяется с фактами в реальном времени, если это не предусмотрено отдельно. Она продолжает текст в наиболее вероятном, с её точки зрения, ключе, и звучит это гладко независимо от того, правда там написана или нет.
Что нейросеть на самом деле "знает"
Тут стоит быть честным: нейросеть не понимает смысл слов так, как его понимает человек. У неё нет представления о мире, боли или ощущения времени. Есть только числовые представления слов и связей между ними, выученные по текстам, которые люди уже написали.
При этом результат часто выглядит осмысленным, потому что сам язык уже содержит в себе много структуры: причина обычно упоминается раньше следствия, вопрос обычно предполагает определённый тип ответа, у предложения есть подлежащее и сказуемое. Нейросеть улавливает эти закономерности настолько хорошо, что со стороны это неотличимо от понимания - до тех пор, пока не встретится ситуация, которой не было в обучающих данных в похожем виде. Тогда модель может выдать уверенный, гладкий и абсолютно неверный ответ, потому что для неё это просто ещё одно правдоподобное продолжение текста.
Разные компании обучают модели по-разному, и это заметно в поведении. Например, Gemini: обзор нейросети Google показывает, что даже при похожей базовой архитектуре итоговый характер модели сильно зависит от того, на каких данных и с каким объёмом дополнительной настройки её доучивали после основного обучения.
Частые заблуждения
- Нейросеть думает. На самом деле она вычисляет наиболее вероятное продолжение текста, а не рассуждает в человеческом смысле. Форма рассуждения возникает потому, что модель училась на текстах, где люди рассуждали вслух, а не потому что у неё появился собственный процесс мышления.
- Нейросеть хранит в себе весь интернет. Она хранит статистику закономерностей текста, а не копию источников. Попросить у неё дословную длинную цитату обычно бесполезно - она либо ошибётся в деталях, либо честно скажет, что не помнит точно.
- Чем больше модель, тем она умнее во всём. Размер помогает, но не линейно и не универсально. Небольшая модель, заточенная под конкретную задачу, часто справляется с ней лучше огромной универсальной.
- Уверенный тон ответа означает, что ответ верный. Уверенность и точность - независимые друг от друга вещи. Модель обучена звучать связно, а не обязательно правдиво.
- Все нейросети одинаковые внутри. Архитектура у многих современных моделей действительно похожа, но объём и состав обучающих данных, число весов и методы дополнительной настройки после обучения отличаются сильно, и от этого зависит итоговое поведение.
Как попробовать самому
Понять, как работает нейросеть, проще всего на практике, а не по описанию. Для этого не обязательно платить: бесплатные нейросети: что реально работает без оплаты и VPN - хороший стартовый список, если хочется просто пощупать, как модель реагирует на разные формулировки одного и того же вопроса.
Если интересно не только пользоваться готовым сервисом, а увидеть механику ближе, можно запустить модель на собственном железе. Это медленнее облачных вариантов и требует более мощного компьютера, зато исключает отправку ваших запросов на сторонний сервер. О том, что для этого нужно и какие модели реально тянет обычный домашний компьютер, рассказано в материале про локальные нейросети: что можно запустить на своём компьютере.
Полезная привычка при знакомстве с любой моделью - задавать один и тот же вопрос по-разному и сравнивать ответы. Если формулировка меняет суть ответа сильнее, чем кажется логичным, это не баг конкретного сервиса, а прямое следствие того, как нейросеть устроена: она реагирует на форму текста запроса, а не считывает намерение так, как это сделал бы человек. Больше материалов о языковых моделях - в архиве рубрики.
Из всего этого вытекает практический вывод: не стоит воспринимать ответ нейросети как факт по умолчанию. Стоит воспринимать его как правдоподобную гипотезу, которую полезно перепроверить, если цена ошибки высока - в медицинском, юридическом или финансовом вопросе особенно. Для черновика текста, идеи или объяснения незнакомого термина такой инструмент отлично годится именно потому, что теперь понятно, на чём основан его ответ.