ИИ усредняет интернет: как массовая генерация контента создает цифровую "Вавилонскую Библиотеку"
Массовое использование ИИ для создания контента ведет к усреднению информации в сети, превращая ее в бесконечное повторение одних и тех же формулировок и лишая интернет разнообразия и смысла.

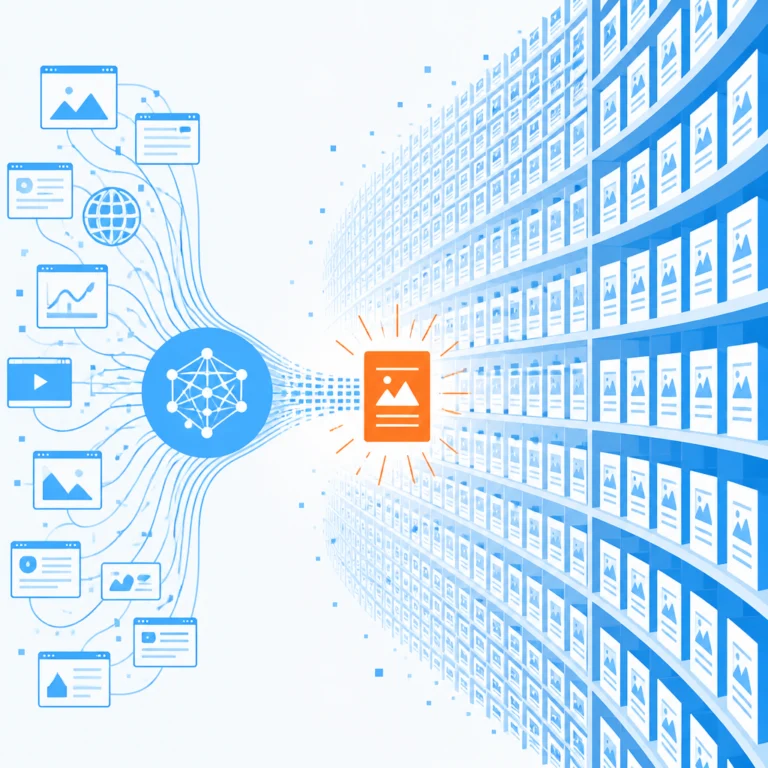
Интернет все больше наполняется контентом, сгенерированным ИИ, что заметно меняет цифровой ландшафт. Поиск по многим темам выдает сотни страниц с практически идентичными формулировками и структурой. Это прямой результат того, как работают языковые модели: они оперируют токенами и статистикой, а не смыслом. Формируется огромный архив текстов без оригинальности - своего рода цифровая Вавилонская библиотека.
Для модели весь текст - это последовательности токенов, которые могут быть представлены как числа, например, 464, 637 или 86. Весь смысл за этими символами вкладывают люди в процессе обучения модели. Генерируемый ИИ текст - это усредненный результат всех данных, на которых модель обучалась. Именно это усреднение и становится ключевой чертой растущего пласта сетевого контента. Общее количество веб-страниц может расти, но их реальная информационная ценность снижается из-за поразительного однообразия.
Корни явления лежат в самих принципах работы больших языковых моделей. Они обучаются на огромных массивах текстов из интернета, предсказывая наиболее вероятные последовательности слов. Когда тысячи таких систем начинают генерировать контент для SEO-статей или описаний, они воспроизводят самые частотные шаблоны, создавая замкнутый круг. Интернет, который был пространством для обмена уникальными идеями, рискует превратиться в эхо-камеру, где один и тот же усредненный сигнал бесконечно отражается.
Для индустрии ИИ это создает конкретные вызовы. Автоматизация создания текстов экономит ресурсы, но одновременно девальвирует ценность информации и подрывает доверие пользователей. Если поисковые системы вроде той, что описана в статье под номером 1084178, начнут возвращать в основном синтетические, шаблонные результаты, их полезность резко упадет. Разработчикам моделей, возможно, придется искать технические способы поощрять большее разнообразие в генерации, например, корректируя подходы к обучению или вводя специальные параметры, влияющие на случайность выбора следующего токена.
Ситуация также ведет к переосмыслению роли человека в создании контента. Машинная генерация прочно займет ниши, где требуется технический текст, сводки или первичные описания - там, где креативность не является критичной. Однако для создания экспертных мнений, глубокого анализа или по-настоящему увлекательных материалов человеческий фактор, понимание тонкого контекста и способность к нестандартным умозаключениям останутся незаменимыми. Без этого интернет может превратиться в ту самую библиотеку из рассказа Борхеса - бесконечное хранилище текстов, в котором почти нет подлинного смысла. Такой сценарий, при котором сеть становится пространством усредненных, шаблонных данных, становится все более вероятным по мере распространения и совершенствования генеративного ИИ. Пользователям, предпринимателям и разработчикам стоит учитывать эти риски, стремясь сохранить баланс между эффективностью автоматизации и ценностью уникального человеческого вклада.