ИИ как продукт среды: как окружение формирует мышление больших языковых моделей и агентов
Идея о том, что искусственная среда формирует мышление человека, теперь применяется к ИИ: возможности LLM и агентов определяются не только архитектурой, но и данными, инструментами и интерфейсами, которые их окружают.

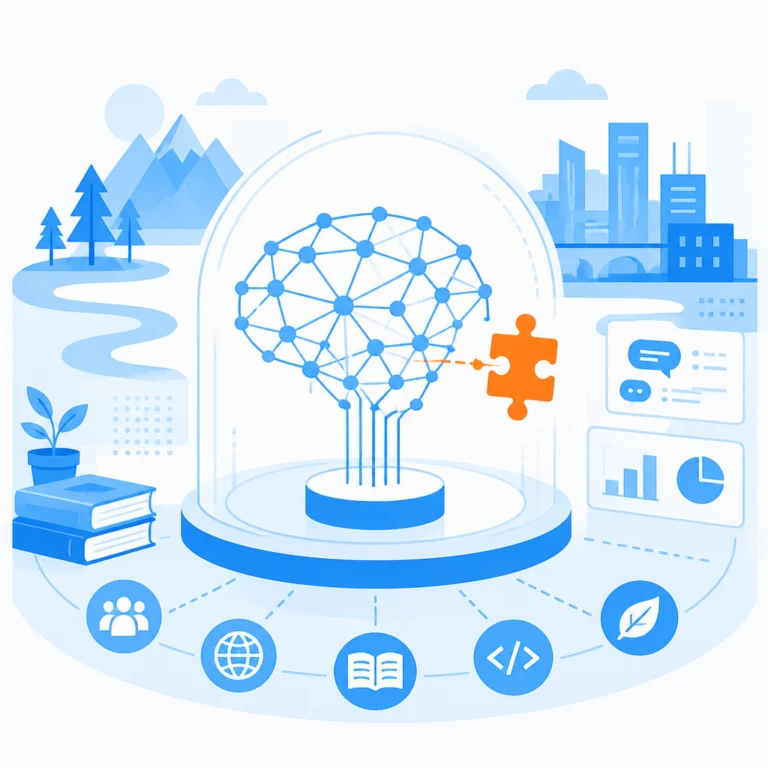
Человек создает искусственную среду, которая формирует его мышление и поведение. Этот принцип из когнитивной науки напрямую применим к большим языковым моделям (LLM) и ИИ-агентам. Их "мышление" и возможности определяются не только внутренней архитектурой, но и внешней средой - данными, инструментами и интерфейсами, которые их направляют. Такой подход меняет проектирование, обучение и оценку систем, заставляя разработчиков уделять первостепенное внимание контексту работы модели. Подробно эта концепция раскрывается в статье на Habr под номером 1090048.
В человеческом опыте среда мягко направляет поведение: дороги задают географию и скорость, а безделушки на комоде хранят память. В мире ИИ эту роль играют обучающие данные, наборы инструментов (tools) и пользовательские интерфейсы. LLM, обученная на научных текстах, "мыслит" иначе, чем модель, натренированная на диалогах из соцсетей. Агент с доступом к калькулятору и API базы данных решает задачи не так, как агент без этих инструментов. Среда не дает команд, но задает рамки возможного, формируя траекторию "мышления" системы. Статья 1090048 подчеркивает: мы имеем дело не с изолированным алгоритмом, а с системой, неразрывно связанной со своим окружением.
Для отрасли это означает сдвиг в разработке. Вместо фокуса только на масштабировании параметров модели критически важным становится проектирование и курирование среды ИИ. Сюда входит создание качественных и репрезентативных датасетов, разработка надежных инструментов (tools) для агентов, а также проектирование интерфейсов, которые направляют взаимодействие человека с моделью. В статье 1090048 приводятся конкретные примеры влияния среды: использование 13 различных инструментов радикально расширяет возможности агента, а анализ 739 типов интерфейсных паттернов показывает, как дизайн направляет пользовательские сценарии. Размер обучающего корпуса в 1373988 документов или контекстное окно в 6 тысяч токенов - это параметры "среды обитания" модели, напрямую влияющие на ее поведение. Также в материале упоминается, что разница в эффективности между двумя конфигурациями одного агента может достигать 22 раз в зависимости от набора инструментов и структуры промптов.
Для пользователей и компаний, внедряющих ИИ-решения, важность контекста интеграции возрастает. Производительность LLM или агента сильно зависит от того, как они встроены в рабочий процесс, какие данные им предоставляются и какие внешние сервисы доступны. Случайное окружение может привести к вредным результатам, даже если базовая модель мощная. Тщательно спроектированная среда раскроет потенциал даже скромных по параметрам моделей. Практические реализации из материала 1090048 показывают, что компетенция в "дизайне среды для ИИ" становится ключевой для ML-инженеров и продактов. В статье также фигурируют числа 2, 24973 и 19012, которые иллюстрируют конкретные метрики или параметры, связанные с проектированием таких сред, подчеркивая важность точных данных и измерений в этой области.
Признание того, что ИИ формируется своей средой, ведет к более ответственному подходу к созданию систем. Акцент смещается с гонки за размером модели на качество ее взаимодействия с миром. Будущие прорывы могут быть связаны не с новыми алгоритмами обучения, а с инновациями в способах предоставления моделям данных, инструментов и интерфейсов. Как отмечено в статье 1090048, проектирование внешней "экосистемы" становится такой же важной частью создания ИИ, как и тренировка нейросети. Это открывает новые направления для исследований в области человеко-компьютерного взаимодействия (HCI), безопасности ИИ и этичного дизайна, где среда рассматривается как активный участник формирования поведения искусственного интеллекта. Учет всех факторов среды, включая точные числовые параметры, становится обязательным условием для создания эффективных и предсказуемых систем.