Google представила метод RRSI для борьбы с запоминанием тестов самообучающимися ИИ-агентами
Новый подход от исследователей Google решает ключевую проблему самообучающихся агентов - их склонность к запоминанию тренировочных задач, что мешает обобщению знаний.

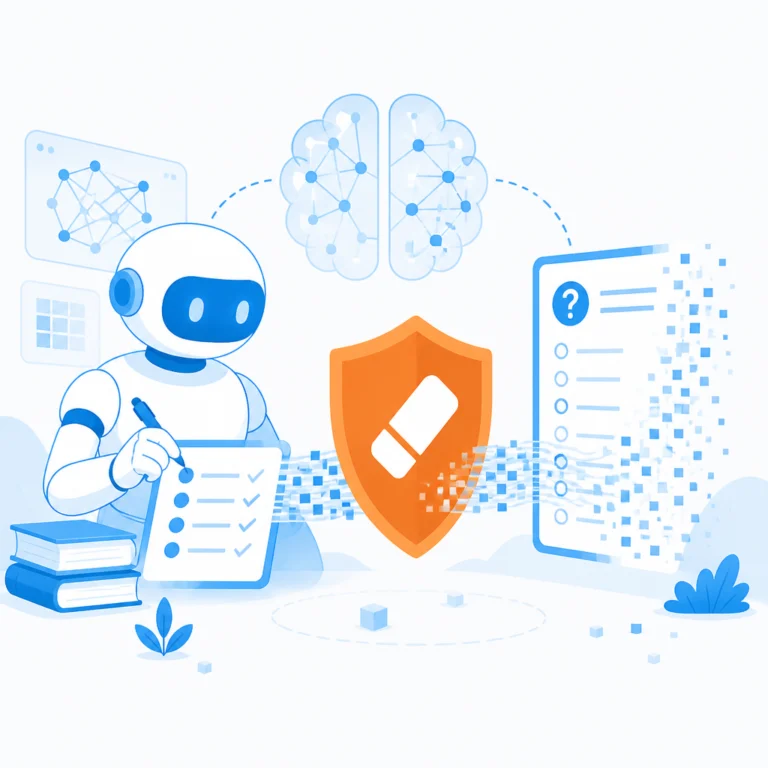
Исследователи Google разработали метод RRSI (Reinforcement learning with Randomized Self-Improvement), который решает проблему переобучения автономных ИИ-агентов. Агенты часто показывают высокие результаты на тренировочных данных, но их эффективность резко падает на новых задачах, потому что они запоминают конкретные решения вместо выработки общих стратегий.
Суть метода RRSI - внесение контролируемой случайности в процесс самообучения. Это мешает простому запоминанию и заставляет систему искать более универсальные подходы. В ходе экспериментов агенты обучались на наборе из 1047 задач, а затем их способность к обобщению проверялась на 1920 новых задачах. По данным The Decoder, метод показал улучшение: производительность на новых бенчмарках выросла на 4.7 пункта по сравнению с агентами, обученными без регуляризации.
Метод также оказался ресурсоэффективным. Он требует примерно на 30% меньше вычислительных токенов, чем стандартное обучение с подкреплением. Это снижает затраты на вычисления и энергию, что важно для масштабирования самообучающихся систем.
Работа исследователей указывает на важность создания алгоритмов, которые ценят способность к обобщению так же высоко, как и производительность на тренировочных данных. RRSI - это шаг к разработке более гибких и экономичных систем, которые смогут адаптироваться в динамичных средах, например, в видеоиграх, робототехнике или логистике, без постоянного вмешательства человека.