Детектор атак на синтетических данных: нейросеть, обученная в выдуманном мире, успешно находит реальные угрозы
Исследователь создал детектор для обнаружения lateral movement, обучив нейросеть исключительно на данных, сгенерированных в смоделированной корпоративной сети, и проверив её на реальных логах Лос-Аламосской лаборатории. Метод показал высокую эффективность, значительно снизив количество ложных срабатываний.

Синтетические данные против реальных атак: детектор, обученный на выдумке
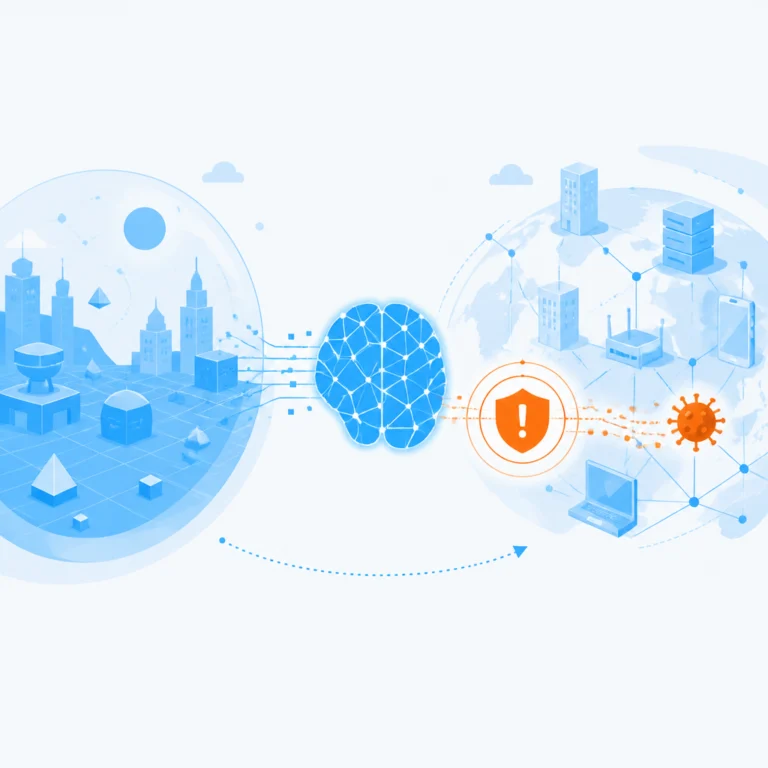
В детектировании сложных атак, таких как lateral movement, существует проблема нехватки данных. Реальные логи атак редки, часто засекречены и неполны. В одном эксперименте исследователь задался вопросом: можно ли создать эффективный детектор, не показывая нейросети настоящую атаку при обучении? Ответ оказался положительным.
Детектор обучали исключительно на синтетических данных, сгенерированных в вымышленной корпоративной сети, описанной конфигурационным файлом на 135 строк. В этой виртуальной среде смоделировали обычную активность пользователей и действия условного противника. Затем модель протестировали на реальных журналах аутентификации Лос-Аламосской национальной лаборатории - 1.65 миллиарда событий, включающих размеченные учения красной команды.
Архитектура нейросети была простой: каждая содержала всего 4188 параметров и обучалась за секунды на обычном ноутбуке. Наилучший результат показал ансамбль из 7 сетей, обученных на 7 разных синтетических "мирах". При обработке реальных данных системы сформировали 3.6 миллиона окон, оцененных по степени подозрительности.
Ключевой метрикой стало соотношение обнаруженных атак к ложным срабатываниям. В верхних 45 строках рейтинга подозрительности оказались 1 настоящая атака и 0 ложных тревог. Это означает, что аналитику для поиска угрозы потребовалось бы проверить всего 1 строку из этого списка. В более широком срезе - среди 50 самых подозрительных событий - было обнаружено 5 реальных атак. Для сравнения: традиционный пороговый метод, настроенный на обнаружение той же 1 реальной атаки, генерировал бы 4 ложных срабатывания. Ручной анализ даже при таком, казалось бы, небольшом потоке все равно требует времени.
Этот успех не означает, что синтетические данные полностью заменяют реальные. Прямое сравнение метрики AUC с другими исследованиями часто некорректно из-за различий в постановке задач. Однако главный вывод состоит в другом: качественно сгенерированные синтетические данные могут стать рабочей основой для практических инструментов обнаружения.
Основное преимущество метода - возможность быстрой итеративной доработки детектора. Когда модель ошибалась на реальных логах, исследователь анализировал, какого паттерна не хватало в виртуальном мире, добавлял в конфиг генератора 1-5 новых строк, перегенерировал данные, переобучал модель - и ошибка часто устранялась. Такой цикл "ошибка - доработка синтетики - переобучение" существенно ускоряет разработку систем обнаружения.
Эксперимент демонстрирует конкретные возможности для кибербезопасности. Во-первых, снижается критическая зависимость от труднодоступных реальных логов атак, что важно для коммерческой разработки или создания решений для новых типов инфраструктур. Во-вторых, подход позволяет создавать и тестировать детекторы для специфических сред (например, промышленных систем или банковских сетей) еще до их физического развертывания, моделируя угрозы в контролируемых условиях. В-третьих, легкость и скорость обучения (секунды на ноутбуке) делают метод доступным для отдельных исследователей и небольших команд, не обладающих вычислительными кластерами.