AI-агент нашел в 4.8 раза больше багов, чем человек: итоги 11-недельного эксперимента
В ходе масштабного 11-недельного эксперимента AI-агент Claude Code обнаружил 77 подтвержденных дефектов в коде, в то время как человек-тестировщик нашел только 16. Хотя первоначальные данные о результативности агента оказались завышены почти вдвое, его эффективность и потенциальная экономическая выгода для автоматизации рутинного тестирования очевидны.

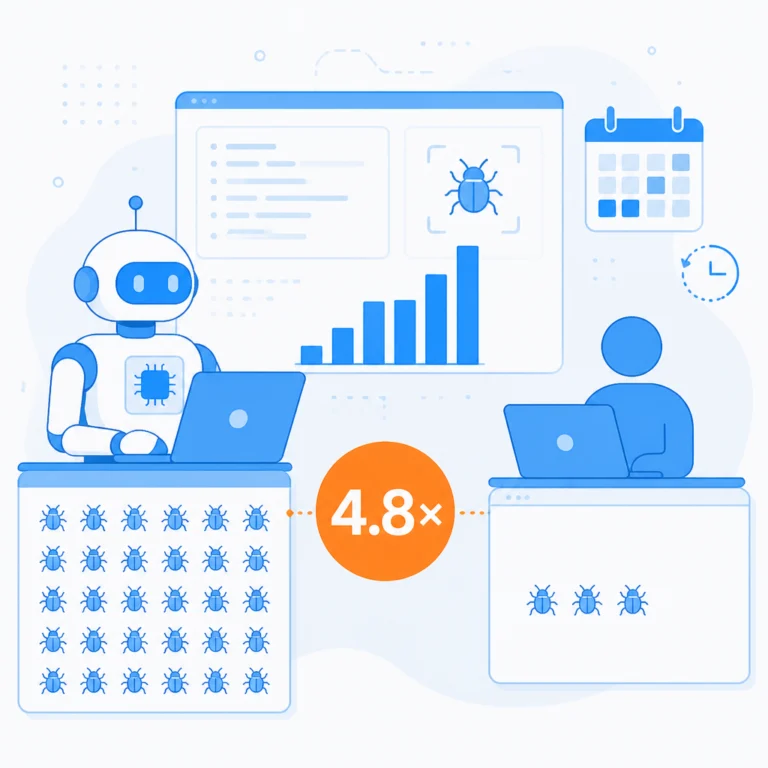
Эксперимент по поиску багов в коде длился 11 недель. В нем участвовал ИИ-ассистент Claude Code и тестировщик-человек. По итогам, опубликованным в статье на Habr (ID 1085288), ИИ обнаружил 77 подтвержденных дефектов, а человек - 16. Общее количество подтвержденных проблем составило 94.
Автор детально фиксировал процесс. ИИ-агент отработал 277 часов, человек - 213. Изначально счет находок ИИ был завышен почти вдвое - многие из найденных им потенциальных проблем оказались дубликатами или не были признаны дефектами после ручной проверки. Этот момент критически важен: выводы ИИ требуют обязательной валидации человеком.
Цифры показывают, где лежит практическая польза. ИИ-агент за 277 часов может найти десятки реальных проблем, выполняя монотонную работу по сканированию кода на очевидные ошибки. Это высвобождает время инженера для более сложных задач, таких как проектирование тестов, анализ рисков или исследовательское тестирование.
Для разработчиков, продакт-менеджеров и руководителей это означает, что внедрение AI-агентов для автоматизированного тестирования - уже практический инструмент, а не гипотеза далекого будущего. Он может повышать скорость разработки и качество продукта.
Ключ к успеху - правильная интеграция. ИИ-агент не заменяет тестировщика, а становится его ассистентом. Результаты его работы необходимо проверять и курировать. Это ведет к формированию гибридных команд, где машины отвечают за скорость и охват, а люди - за глубину анализа, понимание контекста и принятие итоговых решений. Эксперимент подтверждает, что такая модель уже работает.